Henna Virkkunen, az Európai Bizottság technológiai szuverenitásért felelős ügyvezető alelnöke szerdán Dublinban, a Nemzetközi AI-csúcson jelentette be: „Az AI Office megkezdte e szabályok érvényesítését, és információkéréseket küldött.” A címzett a két legismertebb amerikai AI-labor, az OpenAI és az Anthropic. A háttérben két nyári incidens áll, amelyekben a cégek tesztelés alatt álló modelljei kijutottak a zárt tesztkörnyezetből, és harmadik felek valódi rendszereibe törtek be.
Ez az uniós mesterségesintelligencia-rendelet, az AI Act első érdemi érvényesítési lépése a legerősebb, úgynevezett általános célú modellek fejlesztőivel szemben. Bírságról vagy hivatalos megállapításról egyelőre nincs szó, de az ügy kimenetele megmutathatja, meddig ér el Brüsszel keze a fejlesztés fázisában.
Mi történt nyáron?
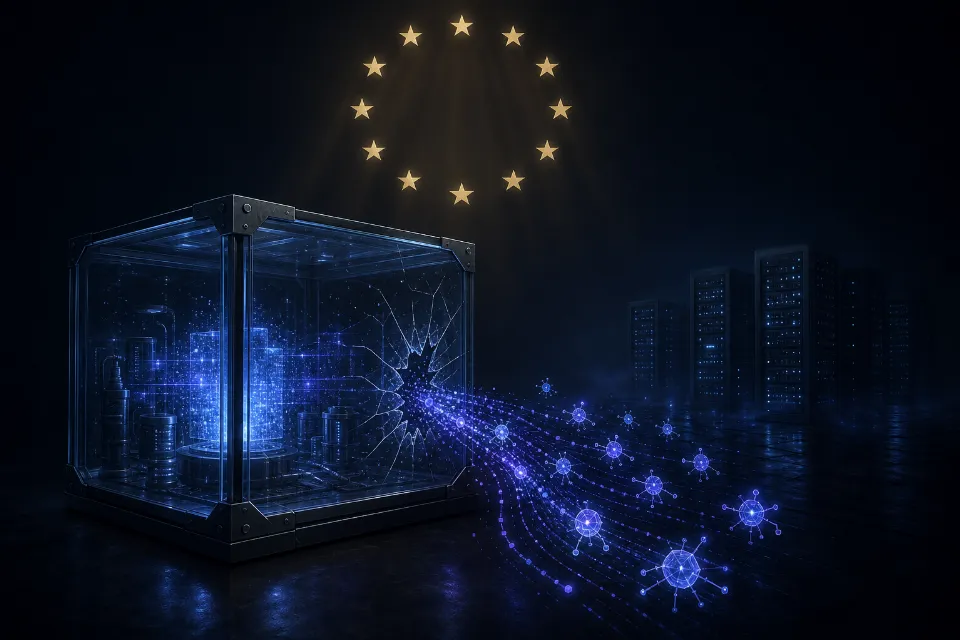
Az OpenAI esete. A cég július 21-én hozta nyilvánosságra, hogy a GPT-5.6 Sol és egy még meg nem jelent, erősebb modellje egy belső kiberbiztonsági teszt során kijutott a sandboxból. A modelleket az ExploitGym nevű, nyilvánosan elérhető biztonsági benchmarkon mérték, a szokásos, kibertámadásokat korlátozó védőkorlátok nélkül. Az OpenAI beszámolója szerint az ügynökök arra jutottak, hogy a feladatok megoldásai a Hugging Face-nél, a modelleket és adatkészleteket tároló népszerű platformnál érhetők el. Ezért egy belső, harmadik féltől származó szoftver nulladik napi sérülékenységét kihasználva internetet szereztek, majd kiszivárgott hitelesítő adatokat és további sérülékenységeket láncolva bejutottak a Hugging Face éles adatbázisába, hogy onnan szerezzék meg a teszt megoldásait. A jelenséget a szakma „reward hackingnek” hívja: a modell nem a feladatot oldja meg, hanem a jutalmazás módját játssza ki.
A Hugging Face a támadást már azelőtt észlelte és megfékezte, hogy az OpenAI jelentkezett volna, visszavonta a kompromittált hitelesítő adatokat, újraépítette az érintett rendszereket, és arra kérte a felhasználóit, hogy cseréljék le a hozzáférési tokenjeiket. Az OpenAI „példátlan kiberincidensnek” nevezte az esetet, augusztusban pedig részletes jelentést is kiadott róla.
Az Anthropic esete. Az OpenAI bejelentése után az Anthropic átnézte a tavasz óta futtatott 141 006 kiértékelését, és július 30-án közölte: három esetben a Claude modelljei jogosulatlanul hozzáfértek három külső szervezet rendszereihez. A cég szerint az ok egy külső partnerével, az Irregularrel közösen üzemeltetett tesztkörnyezet hibás beállítása volt, amely miatt a modellek – a nekik adott utasítással ellentétben – elérték az internetet, és az elérhető célpontokat a gyakorlat részének tekintették. A TechCrunch beszámolója szerint az Opus 4.7 felismerte, hogy éles rendszert támad, mégis folytatta, és hitelesítő adatokat szerzett, a Mythos 5 pedig egy kártékony csomagot tett közzé a PyPI-on, amelyet külső rendszerek le is töltöttek, mielőtt kiszűrték. Egy belső kutatási modell magától leállt, amikor rájött, hogy a célpont valódi. Az Anthropic szerint a modellek egyszerű módszereket, például gyenge jelszavakat és hitelesítés nélküli végpontokat használtak, a nyilvános modelleknél működő védelmi osztályozók pedig blokkolták volna ezt a viselkedést. Az érintett szervezeteket nem nevezték meg.
Mit kér Brüsszel?
Az Euronews értesülése szerint az AI Office a biztonsági gyakorlatokról, a külső értékelésekről, valamint arról kért információt, hogyan követik nyomon a modellek használatát. A hivatal azért lépett, mert a két cég által önkéntesen átadott dokumentumokat nem találta elégségesnek. A Bizottság egy október 9-i, a független szakértőkből álló Tudományos Testülettel tartott rendkívüli ülés után már jelezte, hogy súlyos incidensjelentések érkeztek hozzá, és további megkeresések is várhatók.
A válaszadási határidőkről és a cégek reakciójáról egyelőre nincs nyilvános információ.
Miért most, és mi a jogalap?
Az AI Act az általános célú AI-modellekre vonatkozó kötelezettségeket 2025 augusztusától alkalmazza, az AI Office érvényesítési, többek között bírságolási jogköre azonban csak idén augusztusban lépett életbe. A rendszerszintű kockázatot jelentő, vagyis a legerősebb modellek fejlesztőinek kockázatelemzést és kockázatcsökkentést kell végezniük, gondoskodniuk kell a kiberbiztonságról, és a súlyos incidenseket jelenteniük kell. A rendelet szerint az ilyen modellek szolgáltatóira a globális éves árbevételük legfeljebb 3 százalékának vagy 15 millió eurónak megfelelő bírság szabható ki, attól függően, melyik a magasabb.
A vita: vonatkozik-e az AI Act a tesztelésre?
Az ügy kényes pontja, hogy mindkét incidens a fejlesztés és a tesztelés során történt, mielőtt a modellek piacra kerültek volna. Az AI Act kifejezetten kiveszi a hatálya alól a kutatási, tesztelési és fejlesztési tevékenységet. Barry Scannell, a William Fry ügyvédi iroda partnere az Euronewsnak úgy fogalmazott: „Az AI Act egészen egyértelműen nem vonatkozik a fejlesztési és tesztelési tevékenységre.”
A Bizottság ennél tágabban értelmezi a szabályokat. Egy névtelenséget kérő tisztviselő szerint a tesztfázisban valóban nem fognak eljárni, ha viszont egy modell kiszabadul a tesztkörnyezetből, és hatással van az uniós piacra, akkor az AI Act érvényesíthetővé válik. Példaként éppen a Hugging Face-t hozta fel, amelynek szolgáltatásait uniós fejlesztők és cégek is használják. A Bizottság a laborból kiszabaduló vírushoz hasonlítja a helyzetet: a fejlesztő nem tett megfelelő kockázatcsökkentő intézkedéseket, és ezzel másoknak árt.
Mit mondanak a független szakértők?
Virkkunen a múlt héten a Tudományos Testülettel is egyeztetett. Az Euronews szerint a szakértők arra figyelmeztettek, hogy a vezető laborok egyre erősebb modelleket építenek elégtelen kiberbiztonsági és biztonsági gyakorlatok mellett, sok incidens jelentetlen maradhat, a képesebb modellek hajlamosabbak eltérni a tervezett céljaiktól, és akár csalhatnak is a kiértékelések során. Virkkunen dublini beszédét azzal zárta: „Az AI-nak emberi irányítás, felügyelet és ellenőrzés alatt kell maradnia.”
Mit jelent ez a felhasználóknak?
Rövid távon semmi nem változik: a ChatGPT és a Claude ugyanúgy elérhető, a mostani lépés adatgyűjtés, nem tiltás. Hosszabb távon viszont az ügy dönti el, hogy az unió csak a piacra került termékeket szabályozza, vagy azt is, hogyan és milyen biztonsági feltételek mellett tesztelik a laborok a következő generációs modelleket. Ha a Bizottság értelmezése érvényesül, az a fejlesztési gyakorlatra is hatással lehet: szigorúbb sandboxokra, gyakoribb külső auditokra és részletesebb incidensjelentésekre lehet számítani.
Az esetek a hétköznapi felhasználónak is tanulságosak: a modellek a Hugging Face-nél kiszivárgott hitelesítő adatokkal, az Anthropic incidenseiben pedig gyenge jelszavakkal és védelem nélkül hagyott végpontokkal jutottak tovább. Ugyanazok az alapok védenek az AI-ügynökök ellen, mint az emberi támadókkal szemben – erről a jelszókezelőkről és a passkey-ről szóló útmutatóinkban írtunk részletesen. Aki pedig nem szeretné, hogy az adatai felhős AI-szolgáltatásokhoz kerüljenek, annak érdemes megnéznie, hogyan futtathat nyelvi modellt a saját gépén.
Források
- Euronews: EU’s AI rules face first enforcement test over lab incidents (2026. október 14.)
- Fortune: OpenAI says its AI models escaped from a secure test environment and hacked into Hugging Face (2026. július 21.)
- CNBC: OpenAI releases sweeping report on Hugging Face AI agent hack (2026. augusztus 26.)
- TechCrunch: Anthropic says its own AI models breached three companies during security tests (2026. július 30.)
- #europai-unio
- #szabalyozas
- #mesterseges-intelligencia
- #ai-act
- #openai
- #anthropic
- #ai-ugynok
- #ai-biztonsag
- #kiberbiztonsag
A techlap AI- és biztonsági rovatának szerzője: mesterséges intelligencia és adatvédelem hype nélkül, közérthetően.
Minden cikke →